# Ikke skriv som en robot: llms.txt for AI-agenter
Published: 2026-11-06
Author: Pedro Dias
Canonical: https://digitaldias.com/nb/blog/2026-11-06-robots-txt-llms-txt-ai-agents/
AI-agenter leser innleggene dine for å svare på spørsmål fra noen andre. Du trenger ikke skrive om teksten for deres skyld. Slipp dem inn ved navn i robots.txt, publiser en llms.txt og en Markdown-kopi av hvert innlegg, og sett påstanden øverst i hver del. Noe av dette har forskning bak seg, og noe er et billig veddemål. Innlegget sier hva som er hva, og gir deg oppskriften og en prompt som sjekker din egen blogg.
I morges ba jeg Claude, AI-assistenten jeg jobber med hver dag, om å grille meg om denne bloggen. Jeg hadde en idé: de fleste leserne mine er nå maskiner, ikke mennesker, så innleggene mine burde fange en ny slags oppmerksomhet.
Det første spørsmålet handlet ikke om skriving. Claude ville vite hva påstanden min bygde på. En AI som krever bevis fra meg om AI. Rimelig nok. Jeg pekte på besøkstallene fra Cloudflare, tjenesten som står foran nettstedet mitt, og derfra gikk vi videre.
Her er det økten endte med, og slik gjør du det samme på din egen blogg på en ettermiddag.
## AI-lesere: det andre publikummet på bloggen din
Bloggen din har to slags lesere nå. Mennesker, som leser for historiens skyld. Og AI-agenter, som leser på vegne av noen andre.
Agentene finnes i tre varianter. Treningscrawlere samler tekst til neste modell. Søkecrawlere bygger en indeks for AI-svar. Og brukeragenter henter siden din i sanntid, mens en person venter på svar fra ChatGPT, Claude eller Perplexity. Bare de to siste kan lenke til deg i et svar.
En agent bryr seg ikke om åpningsscenen din. Den hopper over anekdoten, hunden og vitsen du brukte tjue minutter på. Frekt, men effektivt. Den leter etter en påstand den kan plukke ut, med en kilde den kan oppgi.
Da er det fristende å skrive som en maskin. Påstanden først, ingen historie, overskrifter som i en bruksanvisning. Det ville ikke jeg, og Claude dyttet meg ikke dit heller. Vi landet på en arbeidsdeling: menneskene får den personlige tonen, og agenten får en ramme rundt teksten.
Har du ansvar for nettstedet til en bedrift, har du én beslutning å ta her. Skal du slippe disse agentene inn? Mange nettsteder stenger dem ute uten å vite det, fordi Cloudflare [har blokkert AI-crawlere som standard på nye domener siden juli 2025](https://blog.cloudflare.com/content-independence-day-no-ai-crawl-without-compensation/).
## Rammen: det en agent leser før teksten din
Rammen er alt rundt teksten. Ingenting av den endrer hvordan et menneske leser innlegget.
- **robots.txt** nevner hver AI-agent ved navn og slipper den inn.
- **llms.txt** i roten av nettstedet lister opp alle innleggene med et sammendrag på ett avsnitt, i Markdown. Det er et forslag til konvensjon fra [llmstxt.org](https://llmstxt.org/), ikke en standard.
- **En Markdown-kopi** av hvert innlegg ligger ved siden av HTML-en, med en lenke fra head-delen av siden. Agenten får teksten uten menyer, skript og cookie-bannere. Men ingen leverandør jeg har funnet, sier at agentene deres følger den lenken. Cloudflares [Markdown for Agents](https://developers.cloudflare.com/fundamentals/reference/markdown-for-agents/) løser det samme på en annen måte: tjenesten gjør om siden til Markdown for alle klienter som ber om `text/markdown`.
- **En TL;DR** øverst gir påstanden og gevinsten i enkle setninger. Innleggene mine hadde det allerede.
- **Overskriftene begynner med temaet.** Vrien kan komme etter kolon. «[Derfor svikter F12 deg her](/nb/blog/2026-03-05-navigate-to-handler/)» blir da «Nettleserens DevTools: derfor svikter F12 deg her».
- **Første setning i hver del slår fast poenget.** Historien kommer etterpå.
- **En FAQ** til slutt, med ekte spørsmål som overskrifter.
Hjelper dette noe? Den eneste studien jeg fant, [GEO](https://arxiv.org/abs/2311.09735) av Aggarwal og kolleger, skrev om nettsider og målte hvor synlige de ble i svarene fra en generativ søkemotor. Sitater, statistikk og kildehenvisninger hjalp mest, med opptil 40 prosent målt etter forfatternes egen metode. Overskrifter og TL;DR testet de ikke. Den delen er mitt veddemål, og jeg har sagt fra om det.
Selve teksten blir som den var. Jeg åpner fortsatt med en scene, og jeg avslutter fortsatt med et poeng. Det er dette jeg liker: ingenting av det som gjør en tekst god for mennesker, måtte ofres. Agentene hopper fortsatt over poenget til slutt. Deres tap.
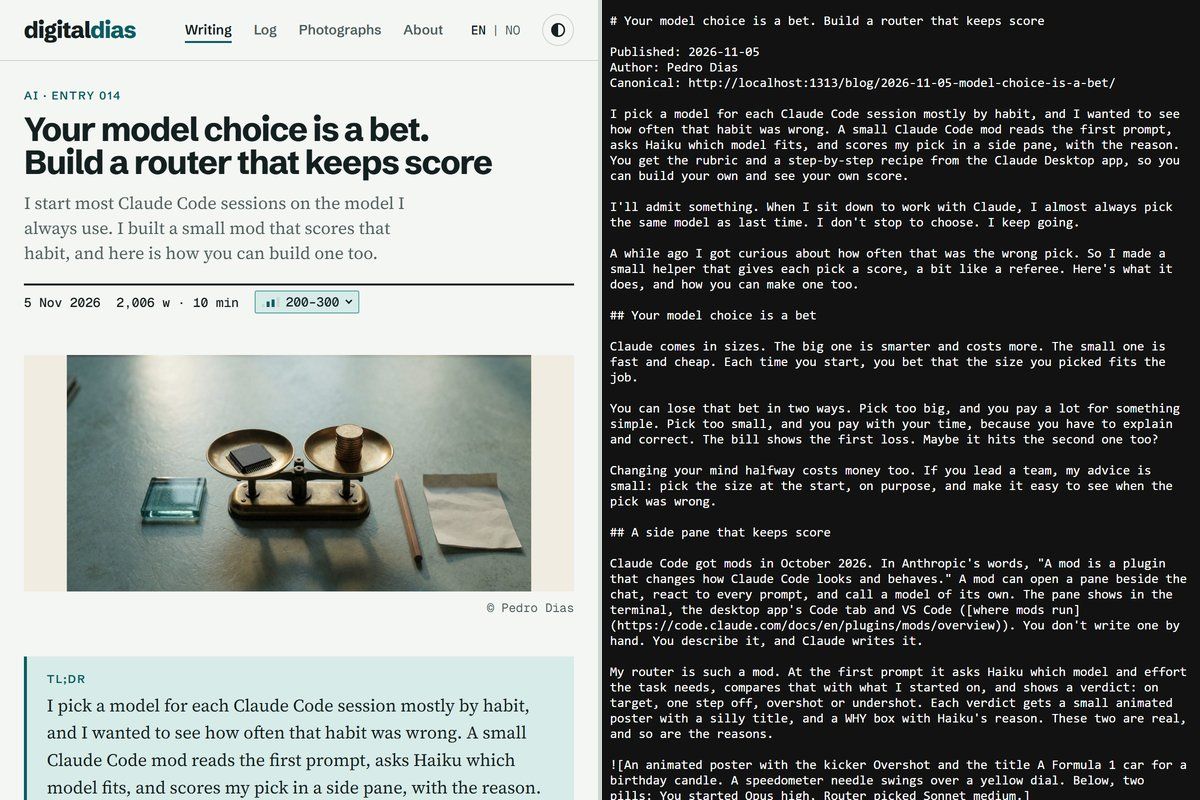
*Det samme innlegget, to ganger. Mennesker får siden til venstre, agentene kopien til høyre. Tatt på utviklingsserveren min, derfor står det localhost i lenkene.*
## robots.txt: slipp agentene inn ved navn
Ja, filen som ønsker roboter velkommen, har hett robots.txt siden 1994. Noen navn eldes med verdighet.
En navngitt gruppe i robots.txt [arver ikke](https://www.rfc-editor.org/rfc/rfc9309) reglene fra `User-agent: *`. Derfor gjentar du `Disallow`-linjene i hver gruppe. Her er agentene til de tre største leverandørene ([OpenAI](https://platform.openai.com/docs/bots), [Anthropic](https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler), [Perplexity](https://docs.perplexity.ai/guides/bots)), i en kortere form enn filen på dette nettstedet:
```text
User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Allow: /
Disallow: /admin/
Sitemap: https://example.com/sitemap.xml
```
Flere `User-agent`-linjer etter hverandre deler én gruppe, og det holder filen kort. `Google-Extended` er ingen crawler. Det er et [token](https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers) som forteller Google om Gemini får trene på det Googlebot allerede har hentet.
Det er én hake. OpenAI og Perplexity sier begge at brukeragentene deres kan hoppe over robots.txt, fordi det er et menneske som har bedt om siden. De navngitte linjene betyr derfor mest for crawlerne som leser filen.
Jeg slipper inn treningscrawlerne også. På en statisk blogg koster de meg ingenting, og en modell som har lest innleggene mine, kjenner kanskje navnet mitt neste gang. Men regn ikke med lenker derfra. En studie fra 2026 fant at 3 til 13 prosent av URL-ene i kildehenvisningene fra språkmodeller og forskningsagenter [aldri hadde eksistert](https://arxiv.org/abs/2604.03173). Du kan godt velge annerledes. Da dropper du bare `GPTBot` og `ClaudeBot`.
Sjekk så Cloudflare, eller hva du ellers har foran nettstedet. En blokkering der overstyrer alt robots.txt sier.
## Sjekk bloggen din: én prompt til din egen Claude
Den raskeste veien krever ingen kode fra meg. Lim inn dette i Claude Code, eller en annen kodeagent, i repoet til bloggen din. Det virker uansett hva bloggen kjører på:
```text
Audit this blog for AI agents that read it on a person's behalf. Keep the writing voice as it is; change only the frame around it.
Check robots.txt: are GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot and Perplexity-User allowed by name? Remember that a named group does not inherit the * group.
Check whether the site publishes /llms.txt (llmstxt.org) and a Markdown copy of each post, linked with . If not, propose how this site's generator can produce both at build time.
Pick the five newest posts. For each, report whether it opens with a summary of its claim, whether its headings name their topic in the first words, and whether each section's first sentence states its point. Suggest a rewrite only for headings and first sentences.
Report as a table first, then the proposed changes. Change no files until I approve.
```
## llms.txt og Markdown-kopier: en oppskrift for Hugo
Dette nettstedet kjører på Hugo, så begge filene lages når siden bygges. Ingen trenger å holde dem oppdatert. Jeg har testet dette på Hugo 0.152.2.
Først definerer du to output-formater i `hugo.toml` og gir forsiden `llms`-formatet:
```toml
[outputFormats.markdown]
mediaType = 'text/markdown'
baseName = 'index'
isPlainText = true
[outputFormats.llms]
mediaType = 'text/plain'
baseName = 'llms'
isPlainText = true
notAlternative = true
[outputs]
home = ['html', 'rss', 'llms']
```
Så slår du på Markdown-kopien for alle innlegg, i front matter-en til `content/blog/_index.md`:
```yaml
cascade:
- outputs: ["html", "markdown"]
target:
kind: page
```
`target` holder selve listesiden for bloggen utenfor. Malen for kopien er `layouts/blog/single.markdown.md`. Dette er den korte versjonen:
```go-html-template
# {{ .Title }}
Published: {{ .Date.Format "2006-01-02" }}
Canonical: {{ .Permalink }}
{{ with .Params.tldr }}
{{ . }}
{{ end }}
{{ .RawContent }}
```
Min egen versjon gjør også om bilde- og callout-shortcodene til vanlig Markdown, fordi `.RawContent` lar dem stå urørt. Be Claude gjøre det samme for dine shortcodes.
Malen for llms.txt er `layouts/index.llms.txt`:
```go-html-template
# {{ site.Title }}
> {{ site.Params.description }}
## Posts
{{ range (where site.RegularPages "Section" "blog").ByDate.Reverse -}}
- [{{ .Title }}]({{ with .OutputFormats.Get "markdown" }}{{ .Permalink }}{{ end }}): {{ .Params.tldr | default .Description }}
{{ end }}
```
Til slutt lenker du til kopien fra head-delen av siden, i head-partialen din:
```go-html-template
{{ with .OutputFormats.Get "markdown" -}}
{{ end -}}
```
Kjør `hugo server`, og åpne `/llms.txt` og `index.md` for et hvilket som helst innlegg. Du skal få ren tekst, med TL;DR-en øverst.
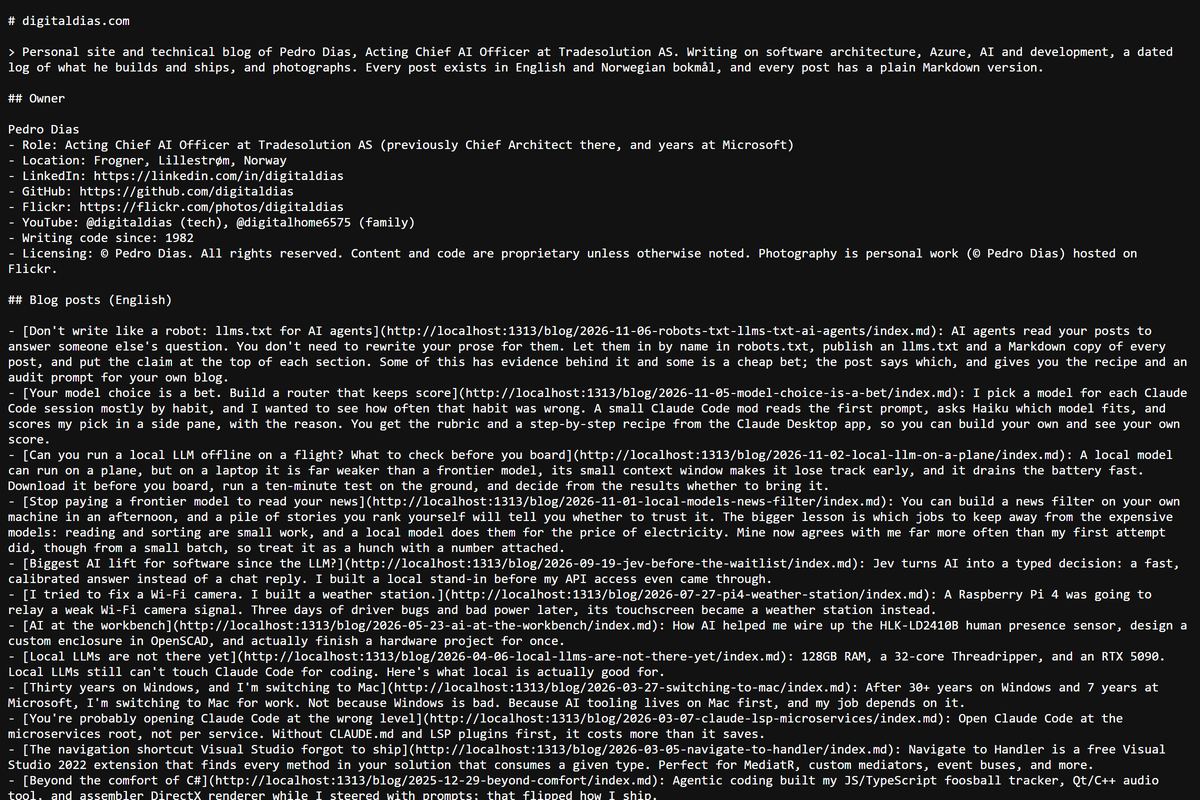
*llms.txt for dette nettstedet, laget av bygget. Ikke pen. Den er ikke ment for deg.*
Alt dette tok meg én økt. Innleggene er de samme. Det er rammen som er ny.
## FAQ
### Må jeg skrive annerledes for AI?
Nei. Behold historien for menneskene. Legg til en TL;DR, sett temaet først i hver overskrift, og slå fast poenget i første setning i hver del. Vil du ha en endring med forskning bak seg, kan du følge rådet fra GEO-studien: siter folk, oppgi tall og vis til kildene dine.
### Leser AI-selskapene llms.txt i det hele tatt?
Ikke som jeg har funnet. John Mueller i Google [sa i juni 2025](https://www.seroundtable.com/google-ai-llms-txt-39607.html) at ingen AI-systemer bruker den, og studiene av serverlogger jeg har sett fra SEO-leverandører, viser svært få forespørsler etter den. Jeg publiserer den likevel. Den kommer gratis ut av bygget, og begynner agentene å lese den, er jeg klar.
### Bør jeg blokkere treningscrawlerne?
Det må du avgjøre selv. Blokkerer du `GPTBot` og `ClaudeBot`, holder du teksten din utenfor neste modell, mens `OAI-SearchBot`, `Claude-SearchBot` og brukeragentene fortsatt kan finne og sitere deg.
### Hvordan vet jeg at det virker?
Se i analyseverktøyet ditt etter besøk som kommer fra chatgpt.com og perplexity.ai. ChatGPT legger ofte til `utm_source=chatgpt.com` på lenkene sine. Hva Claude og Gemini sender med, har jeg ikke sjekket ennå. Se deretter etter agentene ved navn i bot-loggen til CDN-et ditt. Fra nå av følger jeg med på begge for hvert innlegg, så jeg får tall å vise til senere.